Dana 30. 10. 2026. godine, kandidatkinja Sara Đurović odbranila je master rad pod nazivom „Evaluacija sintetičkih skupova podataka o mentalnom zdravlju generisanih velikim jezičkim modelima“, u okviru master studija Informacione tehnologije (modul Softverski inženjering) na Fakultetu za informacione sisteme i tehnologije Univerziteta Donja Gorica, pod mentorstvom prof. dr Toma Popovića i komentorstvom dr Stevana Čakića.
Istraživački i eksperimentalni dio rada djelimično je realizovan uz podršku Nacionalnog centra kompetencija za računarstvo visokih performansi Crne Gore (NCC Montenegro), kroz HPC infrastrukturu i ekspertsku podršku u okviru projekta EuroCC3. Podrškom akademskim istraživanjima i razvoju kompetencija u oblastima AI i HPC tehnologija, NCC Montenegro doprinosi unapređenju primjene naprednih računarskih tehnologija u obradi prirodnog jezika i odgovornom razvoju vještačke inteligencije.
Rad istražuje kako se može procijeniti kvalitet i istraživačka upotrebljivost sintetičkog teksta generisanog velikim jezičkim modelima, na primjeru dnevničkih zapisa o mentalnom zdravlju kao osjetljivog domena u kojem je pristup stvarnim podacima ograničen, sa fokusom na višedimenzionalni evaluacioni okvir umjesto oslanjanja na jednu metriku kvaliteta.
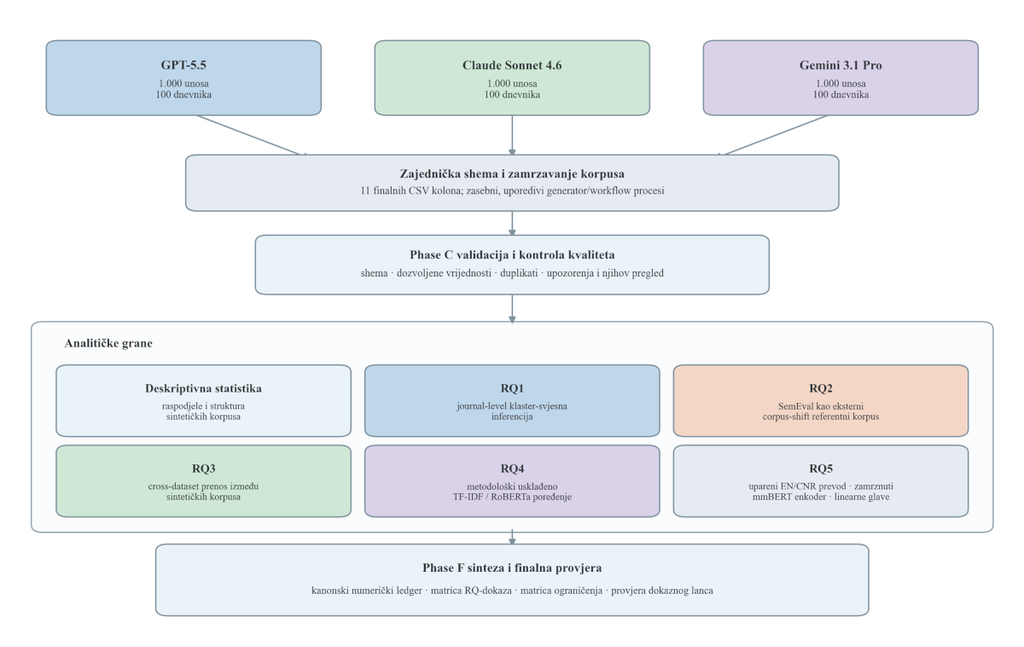
APSTRAKT – Ovaj master rad predstavlja metodološku evaluaciju kvaliteta i istraživačke upotrebljivosti tri sintetička skupa dnevničkih zapisa o mentalnom zdravlju, nastala kroz radne procese zasnovane na modelima GPT-5.5, Claude Sonnet 4.6 i Gemini 3.1 Pro. Svaki skup obuhvata 1.000 unosa u 100 dnevnika, sa zajedničkom shemom podataka i ko-generisanim oznakama, pri čemu se dnevnik tretira kao jedinica statističke nezavisnosti. Evaluacija je obuhvatila cluster-aware permutacionu inferenciju uz Benjamini-Hochberg korekciju, poređenje sa ljudskim referentnim korpusom (SemEval-2026 Task 2) testom klasifikatora nad dva uzorka, eksperimente prenosa između skupova podataka, poređenje TF-IDF i RoBERTa modela, te zero-shot transfer mmBERT reprezentacija između uparenog engleskog i crnogorskog teksta. Skupovi su se statistički razlikovali kod sedam od devet oznaka, a sintetički tekst ostao je jasno razdvojiv od ljudskog i nakon kontrole dužine teksta (balansirana tačnost 0,9855–0,9942). Svih 30 poređenja između skupova pokazalo je pad performansi (26,04%–84,99%), dok je RoBERTa ostvarila viši macro-F1 od TF-IDF modela (0,7872 naspram 0,7118). Rezultati pokazuju da skupovi omogućavaju kontrolisane eksperimente, ali nijesu distribuciono zamjenjivi, te da kvalitet sintetičkih podataka zahtijeva višedimenzionalnu evaluaciju, a ne jednu metriku. Rezultati ne uspostavljaju kliničku validnost oznaka niti rangiraju generatore po kvalitetu.