
Zašto procjena kvaliteta sintetičkog teksta zahtijeva više od jedne metrike uspješnosti
Veliki jezički modeli omogućavaju generisanje uvjerljivog teksta u velikom obimu, otvarajući nove mogućnosti za istraživanja u obradi prirodnog jezika (NLP), posebno u osjetljivim domenima. Sara Đurović je u okviru master rada na Univerzitetu Donja Gorica istražila u kojoj su mjeri sintetički skupovi dnevničkih zapisa o mentalnom zdravlju pogodni za kontrolisane istraživačke eksperimente. Rad je odbranjen 30. oktobra 2026. godine, pod mentorstvom prof. dr Toma Popovića i komentorstvom dr Stevana Čakića.
IZAZOV
Istraživanja zasnovana na tekstovima o mentalnom zdravlju suočavaju se sa ograničenjima u dostupnosti podataka, zaštiti privatnosti i etičkom postupanju. Iako veliki jezički modeli mogu generisati uvjerljive dnevničke zapise, jezička prirodnost ne znači da sintetički podaci odražavaju tekst koji pišu ljudi, omogućavaju pouzdanu evaluaciju modela ili obezbjeđuju prenosivost rezultata na druge skupove.
Ključni izazov bio je razdvojiti tehničku konzistentnost od stvarne istraživačke upotrebljivosti, posebno kada oznake nastaju u istom generativnom procesu kao i tekst, bez nezavisne provjere.
RJEŠENJE
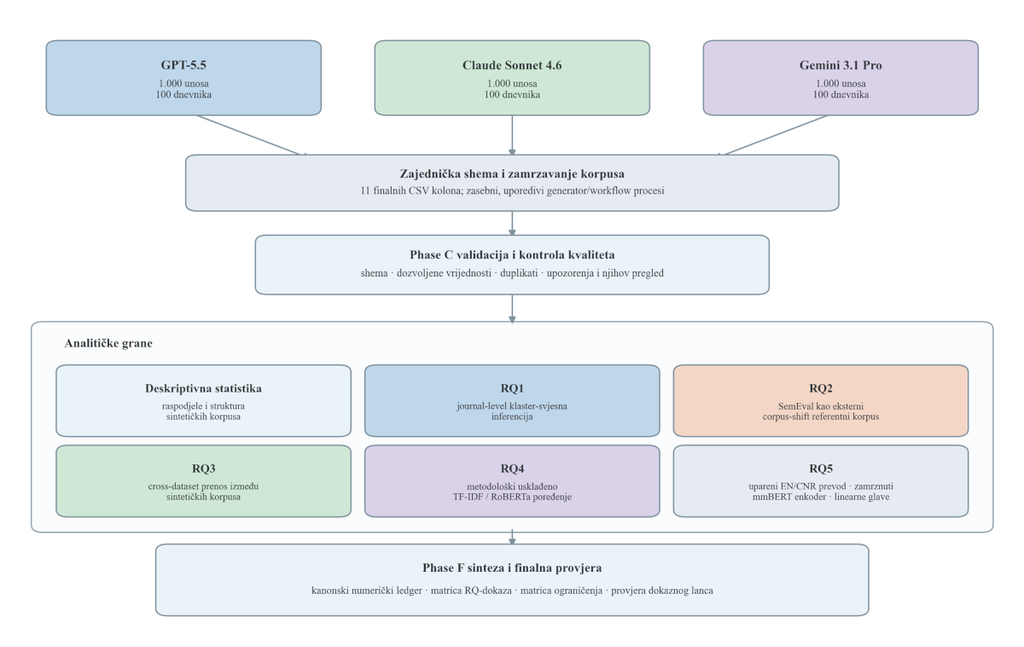
U radu su analizirana tri sintetička skupa dnevničkih zapisa nastala kroz radne procese povezane sa modelima GPT-5.5, Claude Sonnet 4.6 i Gemini 3.1 Pro. Svaki skup obuhvata 1.000 unosa organizovanih u 100 dnevnika, uz zajedničku strukturu podataka. Evaluacija je uvažila grupisanje zapisa po dnevniku kako se povezani unosi ne bi pogrešno tretirali kao statistički nezavisni.
Primijenjeni su strukturna validacija, statistički testovi koji uvažavaju grupisanje podataka, poređenje sa referentnim tekstom koji su napisali ljudi (SemEval-2026 Task 2), eksperimenti prenosa između skupova, poređenje TF-IDF i RoBERTa pristupa, kao i eksploratorni zero-shot prenos između engleskog i crnogorskog jezika pomoću mmBERT reprezentacija.
Računarski zahtjevniji eksperimenti sa RoBERTa i mmBERT modelima sprovedeni su na HPC infrastrukturi, uz čuvanje logova, manifesta i arhiva rezultata radi dokumentovanja analiza.
REZULTATI
Sva tri skupa prošla su strukturnu validaciju, ali su se statistički značajno razlikovala u raspodjeli sedam od devet sintetičkih oznaka. Klasifikator koji razlikuje sintetički od referentnog teksta pisanog od strane ljudi ostvario je balansiranu tačnost od 0,9855 do 0,9942, čak i nakon kontrole dužine teksta, što ukazuje na izražene razlike među korpusima.
U svih 30 poređenja prenosa između skupova zabilježen je pad macro-F1 mjere od 26,04% do 84,99% u odnosu na odgovarajuće evaluacije unutar istog skupa. RoBERTa je na posmatranom zadatku ostvarila viši macro-F1 od TF-IDF polaznog modela (0,7872 naspram 0,7118). Eksploratorni prenos između engleskog i crnogorskog jezika takođe je pokazao ograničenja u apsolutnoj uspješnosti višestruke klasifikacije.
Nalazi potvrđuju da sintetički skupovi mogu poslužiti za kontrolisane NLP eksperimente, ali nijesu distribuciono zamjenjivi. Rad ne dokazuje kliničku validnost generisanih oznaka niti uspostavlja rang-listu kvaliteta jezičkih modela.
BENEFITI
- Pouzdanija evaluacija podataka: Višedimenzionalni okvir koji objedinjuje strukturne, statističke, distribucione i modelske provjere.
- Bolje razumijevanje prenosivosti: Kvantifikovani padovi uspješnosti pri primjeni modela na drugi sintetički skup podataka.
- Eksperimentisanje uz HPC podršku: Računarski resursi omogućili su sprovođenje transformerskih analiza i dokumentovanje rezultata eksperimenata.
- Odgovoran razvoj AI: Praktičan primjer prepoznavanja ograničenja sintetičkih podataka prije njihove šire primjene u osjetljivim oblastima.
Istraživački i eksperimentalni dio rada djelimično je realizovan uz podršku Nacionalnog centra kompetencija za visokoperformansno računarstvo Crne Gore (NCC HPC Montenegro), u okviru projekta EuroCC3.